
وقتی یک سرویس روی سرور لینوکس دچار خطا میشود، اولین جایی که هر مهندسی سراغش میرود، فایلهای لاگ (Log) است. اما در محیطهای عملیاتی (Production) که حجم لاگها میتواند روزانه چند گیگابایت باشد، بازکردن فایل و خواندن خطبهخط آن عملاً غیرممکن است. اینجاست که تحلیل لاگ در لینوکس با کمک چند دستور ساده اما قدرتمند، فرایند عیبیابی (Troubleshooting) را از چند ساعت به چند دقیقه میرساند.
در این مقاله ۱۸ دستور کاربردی برای جستوجو، فیلتر و پردازش لاگهای لینوکس را با هم مرور میکنیم؛ از دستورهای سادهی نمایش متن گرفته تا ابزارهای پیشرفتهتر برای استخراج داده. این مجموعه هم برای مدیران سیستم و هم برای تحلیلگران امنیتی که با لاگ سروکار دارند کاربردی است.
خلاصه: تحلیل لاگ در لینوکس یعنی استفاده از دستورهایی مثل grep، awk، sed، tail و zgrep برای جستوجو، فیلتر و پردازش فایلهای لاگ، بدون نیاز به بازکردن کامل فایل. این دستورها به شما اجازه میدهند در چند ثانیه خطاها، هشدارها یا رخدادهای مشکوک را در حجم زیادی از داده پیدا کنید.
چرا تحلیل لاگ در لینوکس یک مهارت ضروری است؟
لاگها منبع اصلی اطلاعات برای عیبیابی برنامهها و سیستمعامل هستند. مهندسان معمولاً بر اساس تاریخ، زمان، یک کلیدواژه خاص یا شناسه تراکنش (Transaction ID) لاگها را جستوجو میکنند تا ریشه یک مشکل را پیدا کنند. در تجربه متخصص شو در آموزش شبکه و امنیت، یکی از رایجترین ضعفهای مهندسان تازهکار همین است: بلد نیستند بدون باز کردن فایل چندگیگابایتی، خطا را پیدا کنند. یادگیری این دستورها همان چیزی است که این فاصله را پر میکند.
دستورهای تحلیل فایلهای لاگ فشرده (Compressed)
در محیطهای عملیاتی معمولاً لاگهای قدیمی برای صرفهجویی در فضای دیسک فشرده (Compress) میشوند. این سه دستور اجازه میدهند بدون استخراج فایل، محتوای آن را ببینید.
۱. zgrep — جستوجوی متن داخل فایلهای فشرده
دستور zgrep برای جستوجوی یک عبارت یا کلیدواژه داخل فایلهای لاگ فشرده (.gz) استفاده میشود، بدون اینکه لازم باشد فایل را استخراج کنید.
zgrep "ERROR" filename.gz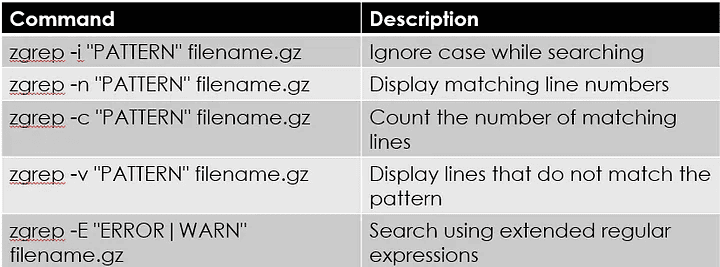
در محیط عملیاتی، این دستور برای جستوجوی سریع کلماتی مثل ERROR، WARN، Exception یا Correlation ID داخل آرشیو لاگها بسیار کاربردی است.
۲. zcat — نمایش محتوای فایلهای فشرده
دستور zcat محتوای یک فایل .gz را بدون استخراج نمایش میدهد و معمولاً خروجی آن به دستورهای دیگر مثل grep یا less هدایت (Pipe) میشود.
zcat filename.gz | less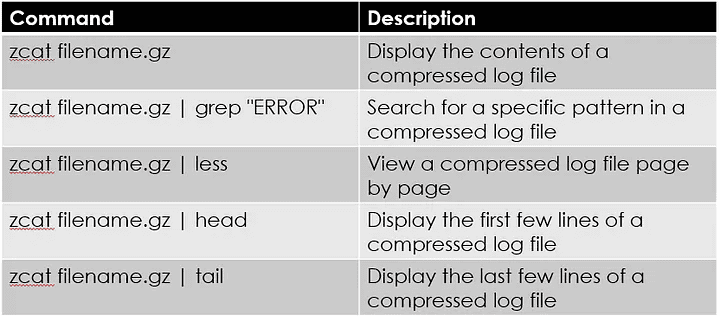
۳. zless — مطالعه صفحهبهصفحه فایلهای فشرده
دستور zless امکان مطالعه فایلهای فشرده بزرگ را بهصورت صفحهبهصفحه و تعاملی فراهم میکند، بدون نیاز به استخراج کامل فایل روی دیسک.
zless filename.gz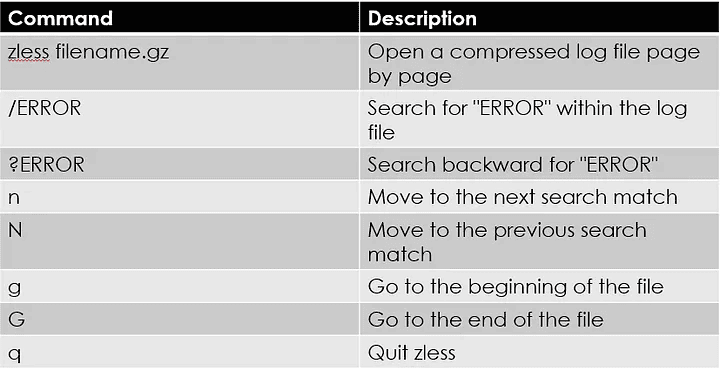
دستورهای پایه برای مشاهده و جستوجوی لاگ
این دسته، پرکاربردترین ابزارهای روزمره در تحلیل لاگ لینوکس هستند و معمولاً اولین ابزاریاند که هر مهندسی سراغشان میرود.
۴. tail — مشاهده جدیدترین رکوردهای لاگ
دستور tail چند خط آخر یک فایل را نمایش میدهد. حالت tail -f یکی از پرکاربردترین دستورها در عیبیابی زنده (Real-time) است؛ زمانی که در حال بازتولید یک خطا، ریاستارت یک سرویس یا بررسی نتیجه یک اصلاح هستید.
tail [OPTIONS] filename.log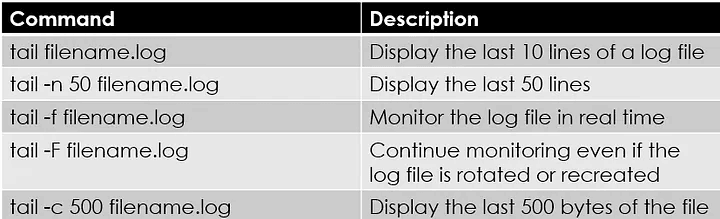
۵. grep — جستوجوی متن در فایلهای لاگ
دستور grep برای جستوجوی یک الگو یا کلیدواژه خاص در فایلهای لاگ استفاده میشود و یکی از پرکاربردترین دستورهای لینوکس در عیبیابی است.
grep [OPTIONS] "PATTERN" filename.log
grep "Exception" app.log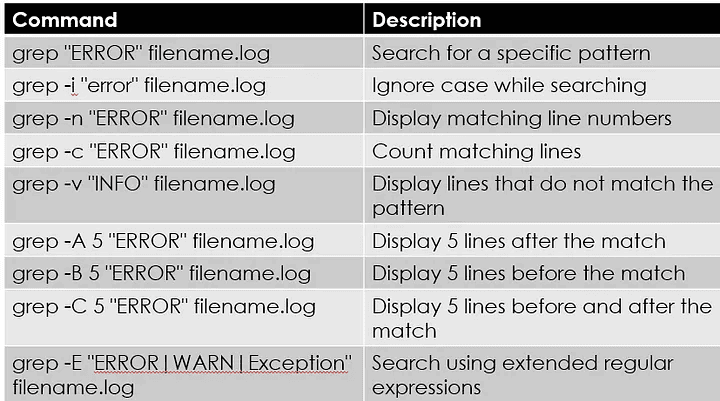
۶. find — پیدا کردن مسیر فایلهای لاگ
وقتی مسیر دقیق فایل لاگ را نمیدانید، دستور find بر اساس نام، نوع، حجم یا زمان آخرین تغییر، فایلها و دایرکتوریها را برایتان پیدا میکند.
find [PATH] [OPTIONS] [EXPRESSION]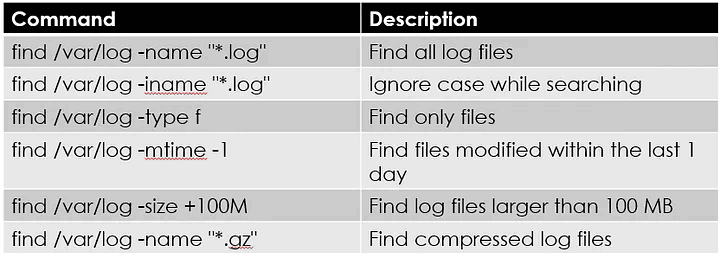
۷. head — نمایش ابتدای فایل لاگ
دستور head چند خط اول فایل را نشان میدهد؛ مناسب برای بررسی سریع هدر لاگ یا پیامهای شروع به کار (Startup) یک برنامه.
head [OPTIONS] filename.log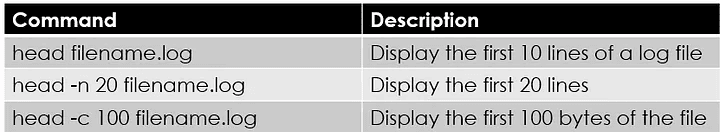
۸. cat — نمایش کامل محتوای فایل
دستور cat فقط برای فایلهای لاگ کوچک مناسب است. برای فایلهای حجیم بهتر است از less یا tail استفاده کنید تا کل فایل در ترمینال بارگذاری نشود.
cat [OPTIONS] filename.log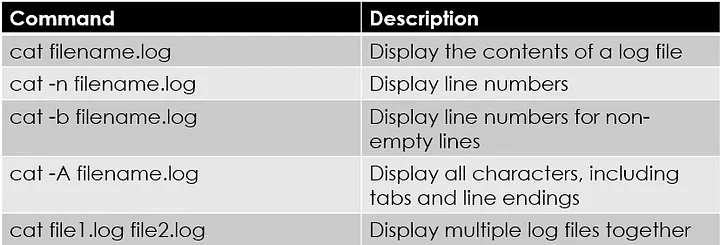
۹. less — خواندن فایلهای لاگ بزرگ
دستور less اجازه میدهد فایلهای بزرگ را صفحهبهصفحه و بدون بارگذاری کامل در حافظه بخوانید و داخل آن جستوجو کنید؛ یکی از پرکاربردترین ابزارها در عیبیابی عملیاتی.
less filename.log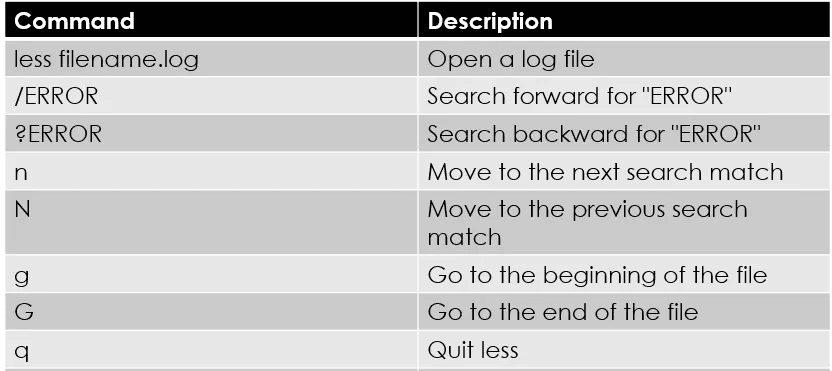
۱۰. vi یا vim — مشاهده و تحلیل تعاملی لاگ
ویرایشگر vi (یا vim) برای باز کردن، جستوجو و پیمایش در فایلهای لاگ استفاده میشود. فعال کردن شماره خط با دستور :set nu ارجاع به رکوردهای خاص لاگ را سادهتر میکند.
vi filename.log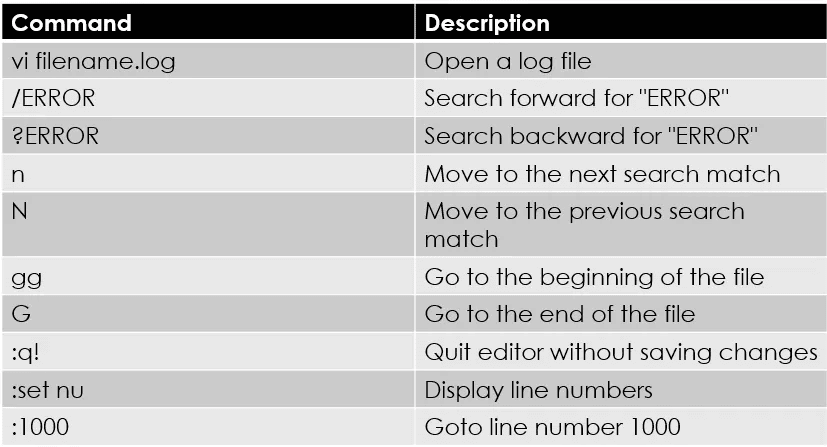
دستورهای پردازش و استخراج داده از لاگ
وقتی صرفاً پیدا کردن یک خط کافی نباشد و نیاز به استخراج، فیلتر یا شمارش داده داشته باشید، این دستورها وارد میدان میشوند. آنها معمولاً در ترکیب با یکدیگر (با کمک Pipe) استفاده میشوند و ستون فقرات هر تحلیل عمیقتر لاگ در سطح تحلیلگر SOC یا مهندس بلوتیم هستند.
۱۱. awk — استخراج و پردازش فیلدهای لاگ
دستور awk برای جستوجو، فیلتر و استخراج فیلدهای مشخص از فایلهای لاگ ساختاریافته استفاده میشود؛ مثلاً استخراج زمان، سطح لاگ (Log Level) یا آدرس IP از هر خط.
awk 'pattern {action}' filename.log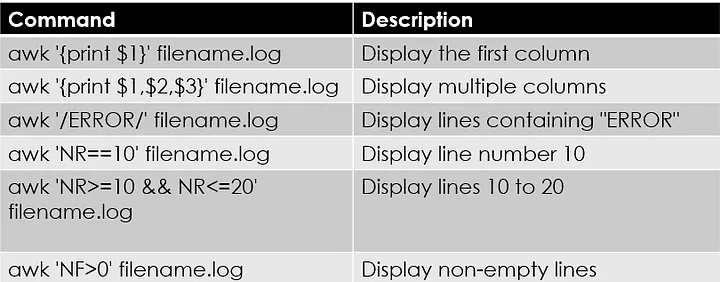
۱۲. sed — فیلتر و ویرایش خروجی لاگ
دستور sed برای فیلتر کردن، جایگزینی، حذف یا چاپ خطوط خاص از فایل لاگ استفاده میشود؛ بهویژه زمانی که نیاز دارید فقط بازه زمانی یا محدودهی مشخصی از خطوط را بدون باز کردن کل فایل ببینید.
sed [OPTIONS] 'COMMAND' filename.log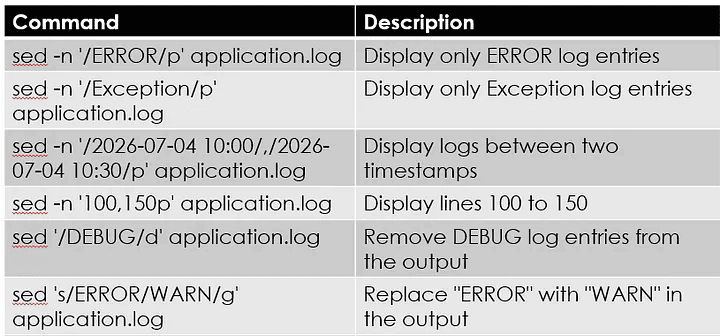
۱۳. cut — استخراج ستونهای مشخص از لاگ
دستور cut ستونها یا فیلدهای مشخصی را از لاگهای ساختاریافته که با یک جداکننده (Delimiter) از هم جدا شدهاند، استخراج میکند؛ مثل استخراج فقط ستون زمان یا نام کاربری.
cut [OPTIONS] filename.log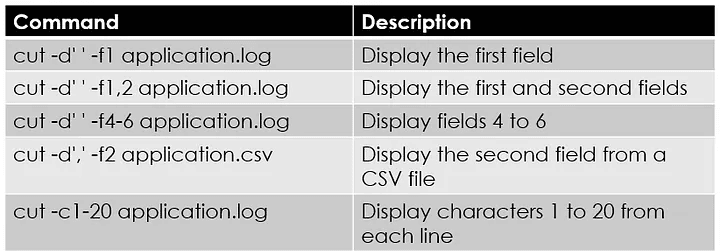
۱۴. sort — مرتبسازی داده لاگ
دستور sort رکوردهای لاگ را به ترتیب حروف الفبا یا عددی مرتب میکند. یک روش کاربردی و پرتکرار در تحلیل لاگ، ترکیب زیر است:
sort application.log | uniq -cاین ترکیب پیامهای تکراری لاگ را بهسرعت شناسایی میکند و یکی از عملیترین کاربردهای sort در تحلیل لاگ محسوب میشود.
sort [OPTIONS] filename.log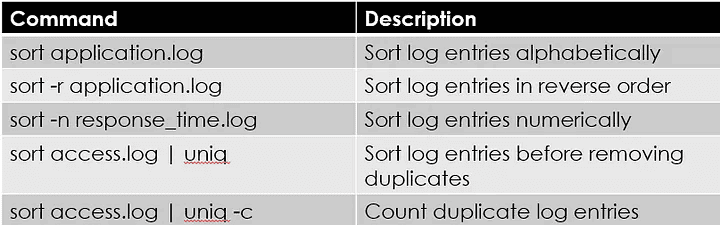
۱۵. uniq — حذف یا شمارش رکوردهای تکراری
دستور uniq فقط روی خطوط تکراری مجاور (Adjacent) عمل میکند، پس همیشه باید پیش از آن از sort استفاده کنید تا پیامهای تکراری یا خطاهای پرتکرار بهدرستی شناسایی شوند.
uniq [OPTIONS] filename.log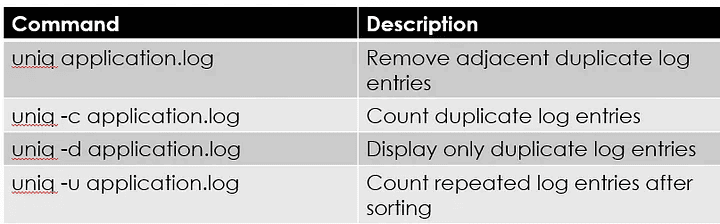
۱۶. wc — شمارش رکوردهای لاگ
دستور wc (شمارش کلمه – Word Count) تعداد خطوط، کلمات یا کاراکترهای یک فایل را میشمارد. استفاده از wc -l پس از فیلتر کردن با grep، تعداد دقیق رخدادهای ERROR یا Exception را بدون شمارش دستی مشخص میکند.
wc [OPTIONS] filename.log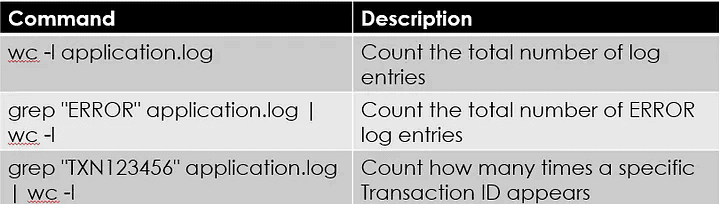
مقایسه فایلها و بررسی فایلهای باینری
۱۷. diff — مقایسه دو فایل لاگ
دستور diff تفاوتهای میان دو فایل لاگ را نشان میدهد؛ مناسب برای مقایسه رفتار سیستم قبل و بعد از یک استقرار (Deployment) یا تغییر پیکربندی.
diff [OPTIONS] file1.log file2.log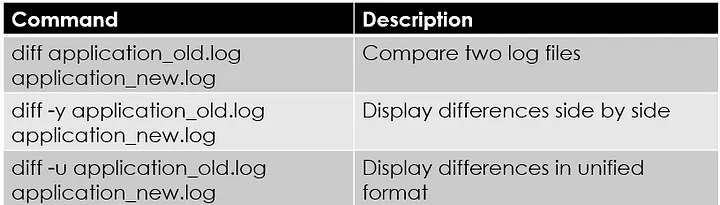
۱۸. strings — استخراج متن قابلخواندن از فایلهای باینری
دستور strings متنهای قابلخواندن را از فایلهای باینری استخراج میکند؛ کاربردی برای بررسی core dump یا فایلهای اجرایی که پیام خطا یا اطلاعات نسخه داخل آنها پنهان است.
strings [OPTIONS] filename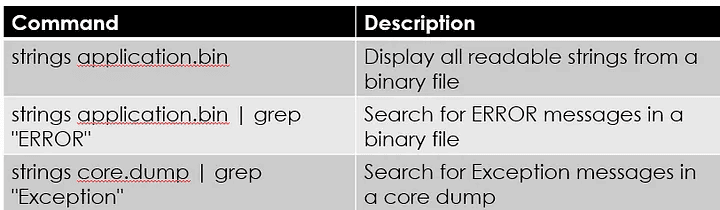
یک مثال عملی: پیدا کردن سریع خطاها در یک لاگ عملیاتی
فرض کنید میخواهید در یک فایل لاگ چندگیگابایتی، پرتکرارترین پیامهای خطا را پیدا کنید. کافی است این دستور را همین امروز روی یک فایل لاگ آزمایشی اجرا کنید:
grep "ERROR" app.log | sort | uniq -c | sort -nr | head -10این خط ابتدا خطوط دارای ERROR را استخراج میکند، سپس آنها را مرتب و تکراریها را شمارش میکند و در نهایت ۱۰ پیام خطای پرتکرار را نشان میدهد. همین یک خط، در بسیاری از سناریوهای واقعی، سریعتر از هر ابزار مدیریت لاگ (Log Management) به شما نشان میدهد که مشکل اصلی کجاست؛ هرچند برای مانیتورینگ مداوم و در مقیاس سازمانی، استفاده از یک ابزار تخصصی مدیریت لاگ همچنان توصیه میشود.
در تحلیلهای امنیتی، همین روش برای پیدا کردن الگوهای مشکوک در لاگ هم کاربرد دارد؛ مثلاً شناسایی تعداد زیاد تلاشهای ناموفق ورود که میتواند یکی از شاخصهای نفوذ (Indicators of Compromise) باشد.
تحلیل لاگ در لینوکس و ارتباط آن با مرکز عملیات امنیت
در بسیاری از سازمانها، تحلیل لاگ فقط یک مهارت فنی برای عیبیابی نیست؛ بخشی از کار روزانه تحلیلگران در مرکز عملیات امنیت (SOC) هم همین است. پیش از رسیدن به ابزارهای پیشرفتهتر مثل SIEM، تسلط بر دستورهای خط فرمان (Terminal) لینوکس، پایه و اساس درک درست از داده خام لاگ است. اگر تازه با محیط خط فرمان لینوکس آشنا میشوید، آموزشهایی مثل تنظیم شبکه در لینوکس با ifconfig نقطه شروع خوبی برای آشنایی بیشتر با محیط لینوکس است.
سؤالات متداول
برای اکثر سناریوها، ترکیب grep برای جستوجو و less برای مرور تعاملی فایل، سریعترین و کمهزینهترین راه است. اگر فایل فشرده است، همین کار را zgrep و zless انجام میدهند.
grep برای پیدا کردن خطوطی که یک الگو دارند مناسب است، اما awk فراتر میرود و میتواند فیلدهای مشخصی از هر خط را استخراج و پردازش کند؛ مثلاً فقط ستون IP یا زمان.
نه، اما آشنایی با ۵ تا ۶ دستور پرکاربرد مثل grep، tail، awk، sort و uniq معمولاً برای ۹۰ درصد سناریوهای عیبیابی روزمره کافی است.
با دستورهای zgrep، zcat و zless میتوانید محتوای فایلهای .gz را مستقیماً جستوجو، نمایش یا مرور کنید، بدون اینکه فضای دیسک اضافی برای استخراج فایل مصرف شود.
uniq فقط خطوط تکراری مجاور را حذف یا شمارش میکند، به همین دلیل همیشه باید پیش از uniq از sort استفاده کنید تا خطوط مشابه کنار هم قرار بگیرند.
جمعبندی
تحلیل لاگ در لینوکس یک مهارت پایه اما بسیار پرکاربرد برای هر مهندس، مدیر سیستم یا تحلیلگر امنیتی است. دستورهایی مثل grep، awk، sed، sort و uniq بهتنهایی یا در ترکیب با هم، میتوانند در چند ثانیه چیزی را پیدا کنند که جستوجوی دستی ساعتها زمان میبرد. پیشنهاد میکنیم همین امروز ترکیب grep | sort | uniq -c را روی یکی از لاگهای خودتان امتحان کنید تا با قدرت واقعی این ابزارها آشنا شوید.


بدون دیدگاه