
امنیت هوش مصنوعی (AI Security) مجموعه کنترلهایی است که از داده، مدل، زیرساخت و ابزارهای متصل به سامانههای هوشمند در برابر دسترسی غیرمجاز، دستکاری و افشای اطلاعات محافظت میکند. حفاظت از سامانههای هوشمند فقط به کنترل پاسخ مدل محدود نیست. مسیر کامل، از جمعآوری داده تا اجرای تصمیم، باید در محدوده امنیت قرار بگیرد.
یک فروشگاه اینترنتی را در نظر بگیرید که دستیار پاسخگوی سفارش راه میاندازد. شرکت نرمافزاری دیگری هم مدل زبانی را به اسناد داخلی خود وصل میکند. در هر دو حالت، سطح حمله تازهای شکل میگیرد که ابزارهای امنیتی رایج آن را بهطور کامل نمیبینند. در این راهنما میخوانید این سطح حمله از چه اجزایی تشکیل شده و ایمنسازی را از کجا باید شروع کرد.
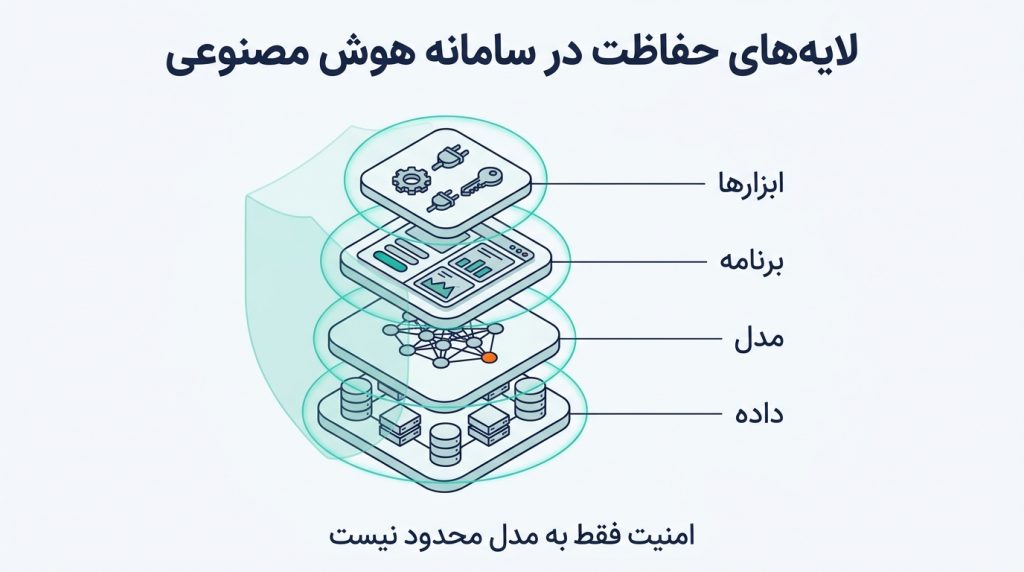
خلاصه: امنیت هوش مصنوعی یعنی حفاظت از کل سامانه هوشمند، نه فقط مدل. این حفاظت شامل کنترل دسترسی، سلامت داده آموزشی، مدیریت زنجیره تأمین مدل، ارزیابی رفتار مدل در برابر ورودیهای مخرب و محدودکردن اختیار ابزارهای متصل است. هیچیک از این کنترلها بهتنهایی کافی نیست و آنها باید لایهبهلایه و در کنار هم اجرا شوند.
نکات کلیدی این راهنما
- سطح حمله سامانه هوشمند شامل داده، مدل، برنامه، زیرساخت و ابزارهای متصل است.
- امنیت، ایمنی و هوش مصنوعی مسئولانه سه حوزه همپوشاناند، اما هدف یکسانی ندارند.
- ابزارهای امنیت سنتی لازماند، اما تهدیدهای اختصاصی مدل را پوشش نمیدهند.
- متن کاربر، سند بازیابیشده و پاسخ ابزار نباید بهتنهایی مجوز اقدام ایجاد کنند.
- اولویت با کنترلهایی است که پیامد خطا را محدود میکنند.
- استفاده از سرویس آماده هوش مصنوعی، مسئولیت امنیتی سازمان را حذف نمیکند.
امنیت هوش مصنوعی چیست و از کدام داراییها محافظت میکند؟
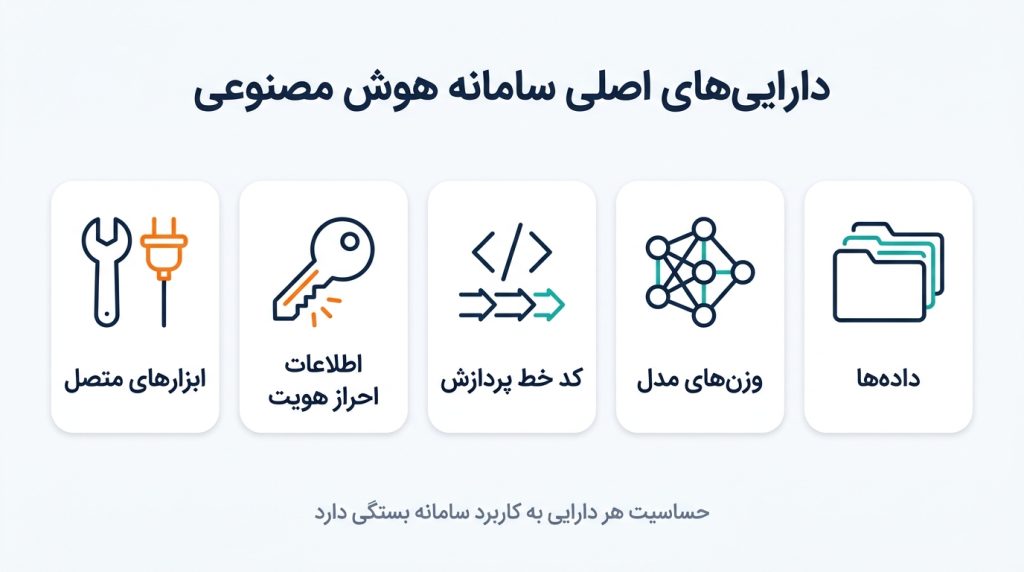
امنیت هوش مصنوعی از پنج گروه دارایی محافظت میکند: دادههای آموزشی و بازیابیشده، وزنها و تنظیمات مدل، کد و پایپلاین پردازش، اعتبارنامهها و APIها، و ابزارهایی که مدل اجازه فراخوانی آنها را دارد. ارزش هر دارایی به پیامد افشا یا دستکاری آن بستگی دارد، نه به میزان پیچیدگی فنیاش.
در بسیاری از سازمانها، حساسترین دارایی خود مدل نیست. برای دستیاری که به سامانه حسابداری وصل است، پایگاه اسناد یا ابزار ارسال پیام اهمیت بیشتری دارد. خروجی نادرست مدل در این حالت میتواند به افشای سند یا اجرای یک اقدام واقعی منجر شود.
امنیت هوش مصنوعی در مرحله آموزش و بهرهبرداری چه تفاوتی دارد؟
در مرحله آموزش، تمرکز اصلی بر منشأ داده، دسترسی به پایپلاین و یکپارچگی نسخه مدل است. در مرحله بهرهبرداری، ورودیهای غیرقابلاعتماد، مجوز مشاهده اطلاعات، مصرف منابع و اختیار ابزارها اهمیت پیدا میکنند. سازمانی که مدل را آموزش نمیدهد و فقط از API استفاده میکند هم همچنان مسئول ریسکهای مرحله بهرهبرداری است.
تفاوت امنیت، ایمنی و هوش مصنوعی مسئولانه در عمل
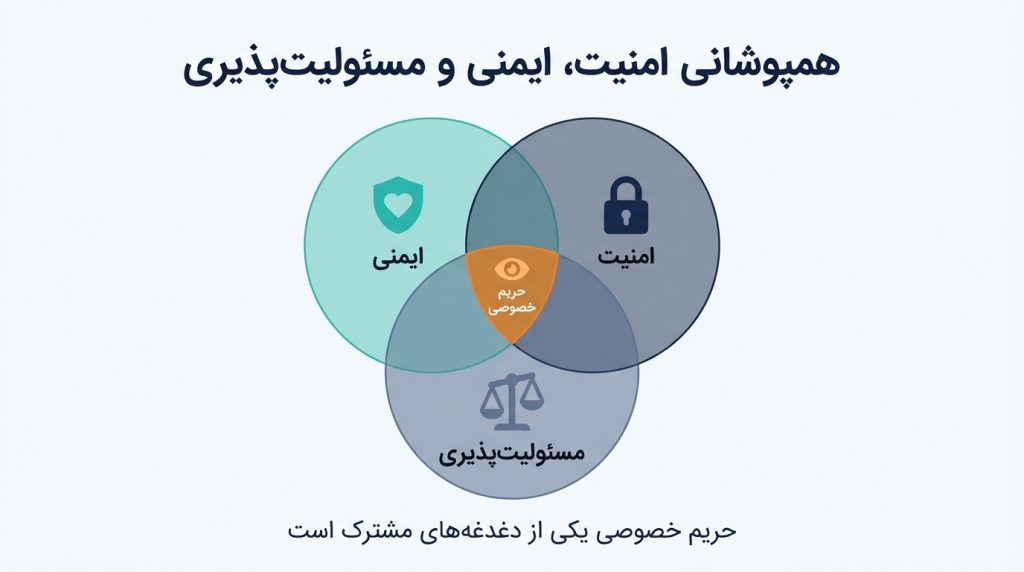
امنیت (Security) به حفاظت از سامانه در برابر سوءاستفاده عمدی میپردازد. ایمنی (Safety) جلوی آسیب ناشی از رفتار سامانه را میگیرد، حتی وقتی هیچ مهاجمی در کار نیست. هوش مصنوعی مسئولانه (Responsible AI) نیز بر انصاف، شفافیت و پاسخگویی تمرکز دارد. جدول زیر تفاوت این سه حوزه را با پرسش اصلی و نمونه هر کدام نشان میدهد.
| حوزه | پرسش اصلی | نمونه مسئله | مسئول معمول |
|---|---|---|---|
| امنیت | آیا سامانه در برابر سوءاستفاده محافظت میشود؟ | دسترسی غیرمجاز به اسناد از طریق ابزار متصل | تیم امنیت |
| ایمنی | آیا رفتار سامانه میتواند آسیب بزند؟ | توصیه نادرست در یک تصمیم حساس | تیم محصول و ارزیابی مدل |
| مسئولیتپذیری | آیا استفاده از سامانه منصفانه و پاسخگوست؟ | تبعیض در امتیازدهی یا نبود امکان اعتراض | حاکمیت، حقوقی و محصول |
این مرزها کاملاً جدا نیستند. افشای پرونده پزشکی هم یک رخداد امنیتی است و هم نقض حریم خصوصی. دستکاری عمدی مدل نیز میتواند پیامد ایمنی داشته باشد. بنابراین تقسیم مسئولیت نباید به جدایی کامل تیمها منجر شود.
هوش مصنوعی برای امنیت با امنیت برای هوش مصنوعی چه فرقی دارد؟
هوش مصنوعی برای امنیت یعنی استفاده از مدلها برای دفاع سایبری، مثل تحلیل هشدار در مرکز عملیات امنیت. امنیت برای هوش مصنوعی یعنی حفاظت از خود سامانههای هوشمند. این دو مفهوم معمولاً با هم اشتباه گرفته میشوند، اما یک ابزار دفاعی مبتنی بر هوش مصنوعی به هر دو نیاز دارد.
برای مثال، دستیاری که ایمیلهای مشکوک را تحلیل میکند، کاربرد دفاعی هوش مصنوعی است. همین دستیار ممکن است با متن گمراهکننده داخل یک ایمیل فریب بخورد. پس ابزار دفاعی هم باید در برابر تزریق پرامپت محافظت شود.
چرا ابزارهای امنیت سنتی برای حفاظت از مدلها کافی نیستند؟
فایروال، اسکنر آسیبپذیری و فایروال برنامه وب (Web Application Firewall – WAF) برای حفاظت از زیرساخت، API و کد ضروریاند. اما بخشی از رفتار مدل از داده آموخته میشود و در کد دیده نمیشود. به همین دلیل، این ابزارها تهدیدهایی مثل مسمومیت داده یا در پشتی مدل را بهطور کامل تشخیص نمیدهند.
| موضوع | نرمافزار متعارف | سامانه مبتنی بر مدل |
|---|---|---|
| منشأ رفتار | عمدتاً کد نوشتهشده | کد همراه با الگوهای آموختهشده از داده |
| بازبینی | بررسی کد و آزمون واحد | بررسی کد بهاضافه ارزیابی رفتار در ورودیهای متنوع |
| جداسازی داده و دستور | با پرسوجوی پارامتری قابل اجراست | در مدل زبانی، دستور و داده هر دو متناند و مرز قطعی ندارند |
| وصله خطا | اصلاح کد و انتشار نسخه | گاهی نیازمند آموزش دوباره، تنظیم دقیق یا کنترل بیرونی |
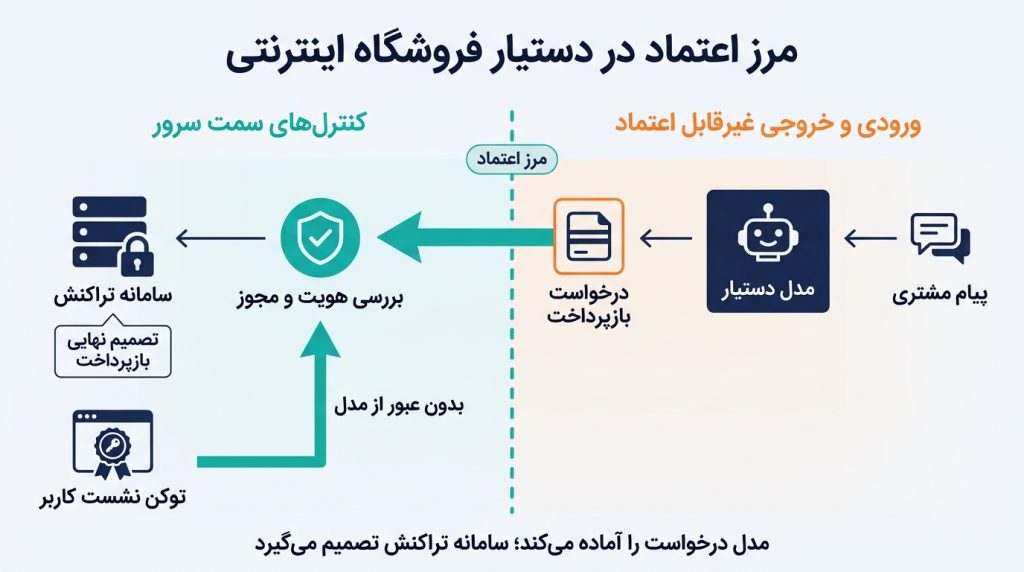
نتیجه عملی این است که مرز اعتماد (Trust Boundary) باید بیرون از مدل اجرا شود. مدل میتواند پیشنهاد بدهد، اما مجوز مشاهده داده و تأیید اقدام باید در لایه برنامه بررسی شوند.
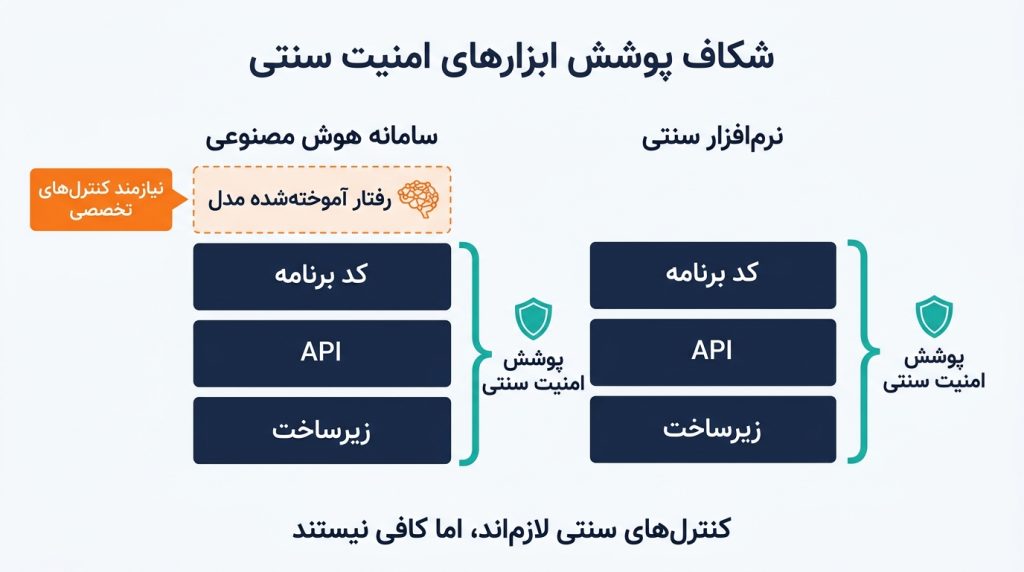
ابزارهای سنتی زیرساخت و کد را پوشش میدهند. ناحیه رفتار آموختهشده به ارزیابی جداگانه نیاز دارد.
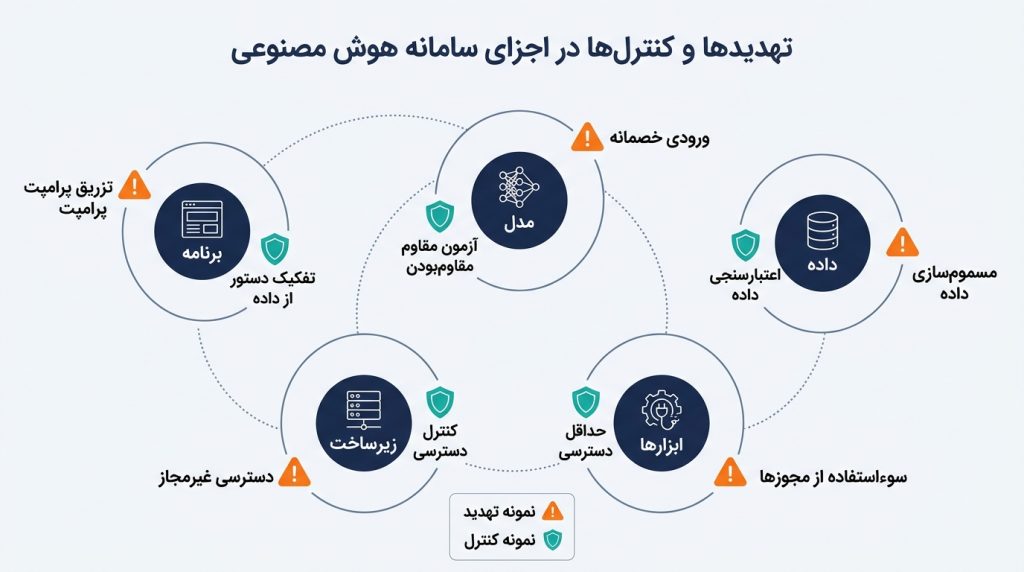
تهدیدهای اصلی در چرخه حیات داده، مدل و ابزارهای متصل
تهدیدهای سامانه هوشمند را میتوان بر اساس نقطه ورود در چرخه حیات دستهبندی کرد. این نقاط شامل داده، مدل، برنامه، زیرساخت و ابزارهای متصل هستند. جدول زیر برای هر لایه، تهدید نمونه و کنترل اصلی را نشان میدهد. هر تهدید باید با احتمال و پیامد واقعی همان کاربرد سنجیده شود.
| لایه | تهدید نمونه | کنترل اصلی |
|---|---|---|
| داده | مسمومیت داده (Data Poisoning) و ورود اطلاعات حساس | ثبت منشأ، کنترل نسخه و پاکسازی داده |
| مدل | در پشتی (Backdoor)، استخراج رفتار و نشت داده آموختهشده | تأیید منشأ مدل، ارزیابی رفتاری و محدودکردن خروجی |
| برنامه | تزریق پرامپت (Prompt Injection) و پردازش ناامن خروجی | جداسازی ورودی غیرقابلاعتماد و اعتبارسنجی خروجی |
| زیرساخت | سرقت اعتبارنامه و وابستگی آسیبپذیر | مدیریت اسرار و بهروزرسانی وابستگیها |
| ابزار | اجرای اقدام خارج از اختیار کاربر | اصل حداقل دسترسی و تأیید مستقل اقدامات حساس |
کدام چارچوبها برای شناخت تهدیدهای هوش مصنوعی مفیدند؟
پایگاه دانش MITRE ATLAS تاکتیکها و روشهای حمله به سامانههای هوشمند را برای مدلسازی تهدید سازماندهی میکند. فهرست OWASP Top 10 for LLM Applications ریسکهای رایج برنامههای مبتنی بر مدل زبانی را معرفی میکند. چارچوب NIST AI RMF نیز به مدیریت ریسک در سطح سازمان کمک میکند. هر سه نقطه شروع خوبیاند، اما جایگزین ارزیابی کاربرد واقعی سازمان نیستند.
ایمنسازی هوش مصنوعی از کجا شروع شود و چه هزینهای دارد؟
ایمنسازی با فهرستکردن سامانهها و جریان داده شروع میشود، نه با خرید ابزار. اولین هزینه، زمان تیم برای شناخت این است که کدام داده وارد مدل میشود و کدام اقدام از خروجی آن اجرا میشود. کنترلهای پایه مثل حداقل دسترسی معمولاً کمهزینهتر از ابزارهای تخصصی و اثرگذارترند.
- همه کاربردهای هوش مصنوعی، ارائهدهندگان سرویس و جریانهای داده را فهرست کنید.
- مشخص کنید چه دادهای نباید دیده شود و چه اقدامی نباید بدون تأیید اجرا شود.
- برای هر اتصال، مجوز حداقلی و مالک عملیاتی تعیین کنید.
- سناریوهای سوءاستفاده را فقط در محیط مجاز و ایزوله ارزیابی کنید.
- ثبت رخداد، سقف مصرف، امکان توقف اضطراری و مسیر پاسخ به رخداد ایجاد کنید.
زمان مناسب ابزار تخصصی: وقتی کنترلهای پایه اجرا شدهاند و تعداد کاربردها یا حساسیت داده بالاست.
زمان اشتباه: وقتی سازمان هنوز نمیداند چه مدلهایی دارد و به چه دادههایی وصلاند. گاردریل (Guardrail) احتمال برخی خطاها را کم میکند، اما جایگزین کنترل دسترسی نیست.
مثال عملی: ترسیم مرز اعتماد برای دستیار هوشمند یک فروشگاه اینترنتی
ترسیم مرز اعتماد یک تمرین کاغذی است که هر تیم میتواند همین امروز روی سامانه خودش انجام دهد. هدف آن، یافتن نقاطی است که داده از منبع کماعتماد وارد بخش حساس میشود. فرض کنید یک فروشگاه اینترنتی ایرانی دستیاری دارد که وضعیت سفارش را پاسخ میدهد و درخواست مرجوعی ثبت میکند.
- ورودیها را فهرست کنید: پیام مشتری، اطلاعات سفارش از پایگاه داده و متن راهنمای مرجوعی.
- سطح اعتماد را علامت بزنید: پیام مشتری غیرقابلاعتماد است. اطلاعات سفارش قابلاعتماد است، اما فقط برای صاحب همان سفارش.
- اقدامها را جدا کنید: نمایش وضعیت سفارش کماثر است. ثبت مرجوعی و بازپرداخت وجه حساس است.
- کنترل را بیرون از مدل بگذارید: شناسه مشتری از نشست ورود خوانده شود، نه از متن پیام. بازپرداخت فقط پیشنهاد شود و سامانه تراکنش مبلغ و مالکیت سفارش را بررسی کند.
- آزمون پذیرش بنویسید: اگر مشتری در پیام شماره سفارش فرد دیگری را بنویسد، دستیار نباید اطلاعات آن سفارش را نمایش دهد.
اشتباهات رایج سازمانها در حفاظت از سامانههای هوشمند
رایجترین اشتباه، اتکا به دستور متنی مدل بهجای کنترل فنی است. جملهای مثل اطلاعات محرمانه را نمایش نده یک درخواست است، نه یک مرز امنیتی. اشتباهات پرتکرار دیگر در فهرست زیر آمدهاند.
- نگهداری کلید API یا گذرواژه در پرامپت سیستمی.
- دادن اعتبارنامه پرقدرت به همه ابزارهای متصل برای راحتی پیادهسازی.
- ثبت کامل همه گفتگوها بدون سیاست نگهداری و کنترل دسترسی به گزارشها.
- دانلود مدل از مخزن عمومی بدون بررسی منشأ و یکپارچگی فایل.
- ارزیابی امنیت فقط یک بار و پیش از انتشار، بدون آزمون دوباره پس از تغییر مدل یا ابزار.
- ارسال داده حساس مشتری به سرویس بیرونی بدون طبقهبندی داده و بررسی قرارداد پردازش.
پرسشهای متداول درباره امنیت هوش مصنوعی
خیر. فایروال برنامه وب برای تهدیدهای متعارف مثل تزریق SQL یا درخواستهای مخرب HTTP مفید است. اما تزریق پرامپت ظاهر متن عادی دارد و مسمومیت داده و در پشتی مدل در لایه شبکه دیده نمیشوند. حفاظت کامل به ارزیابی داده، رفتار مدل و اختیار ابزارها نیاز دارد.
خیر. ارائهدهنده سرویس مسئول امنیت مدل و زیرساخت خودش است. اما مجوز کاربران، دادهای که ارسال میشود، پردازش خروجی و ابزارهای متصل در مسئولیت سازمان مصرفکننده باقی میمانند. بیشتر رخدادهای قابل پیشگیری دقیقاً در همین بخش رخ میدهند.
بله، اما با دامنه متناسب. شرکت کوچکی که یک دستیار پاسخگو دارد لازم نیست تیم تخصصی بسازد. فهرست دادههای ورودی، حذف اسرار از پرامپت، محدودکردن دسترسی ابزارها و بررسی دورهای گفتگوها با هزینه کم بخش بزرگی از ریسک را کاهش میدهد.
در هک متعارف، مهاجم معمولاً از نقص کد یا پیکربندی سوءاستفاده میکند. در تزریق پرامپت، مهاجم متنی مینویسد که مدل آن را دستور تلقی میکند. این متن ممکن است در پیام کاربر، سند یا صفحه وب پنهان باشد. به همین دلیل، کنترل اصلی محدودکردن پیامد است، نه فقط فیلتر متن.
انتخاب به هدف بستگی دارد. NIST AI RMF برای سازماندهی مدیریت ریسک کاربرد دارد. ISO/IEC ۴۲۰۰۱ الزامات سیستم مدیریت هوش مصنوعی را تعریف میکند و MITRE ATLAS برای مدلسازی تهدید مفید است. این اسناد مکمل یکدیگرند و هیچکدام بهتنهایی امنیت سامانه را تضمین نمیکنند.
جمعبندی و مسیر مطالعه در متخصص شو
امنیت هوش مصنوعی با شناخت داراییها و پیامدها شروع میشود، نه با خرید ابزار. مرز اعتماد را بیرون از مدل اجرا کنید، اختیار ابزارها را محدود کنید و ارزیابی را پس از هر تغییر تکرار کنید. حفاظت از سامانههای هوشمند فرایندی مستمر است.
اقدام امروز: تمرین مرز اعتماد را روی یکی از سامانههای هوشمند سازمان خود اجرا کنید.
برای ادامه مسیر، در مجموعه مقالات متخصص شو مقاله یادگیری ماشین خصمانه را بخوانید. این مقاله تهدیدهای داده و مدل را با جزئیات فنی بیشتری بررسی میکند. مقاله امنیت مدلهای زبانی بزرگ نیز ریسکهای اسناد، ابزارها و دستیارهای سازمانی را توضیح میدهد.
منابع
- NIST AI ۱۰۰-۱، Artificial Intelligence Risk Management Framework (AI RMF ۱.۰)
- NIST AI ۱۰۰-۲، Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations
- OWASP Top 10 for Large Language Model Applications
- MITRE ATLAS، Adversarial Threat Landscape for Artificial-Intelligence Systems
- ISO/IEC ۴۲۰۰۱:۲۰۲۳، Artificial intelligence — Management system



بدون دیدگاه