
وقتی یک حمله باجافزاری در نیمهشب یک سرور حیاتی را قفل میکند، اولین سؤالی که ذهن هر تحلیلگر امنیتی را درگیر میکند این است: «الان از کجا شروع کنیم؟». پاسخ به این سؤال دقیقاً همان چیزی است که پاسخ به حادثه (Incident Response) به آن میپردازد. بدون یک فرآیند مشخص، سازمانها در لحظه بحران دچار سردرگمی میشوند، زمان از دست میرود و خسارت چند برابر میشود.
در این مقاله بهصورت کامل بررسی میکنیم پاسخ به حادثه چیست، چه مراحلی دارد، چه تیم و ابزارهایی پشت آن قرار میگیرد و چطور میتوان یک برنامه عملی برای آن نوشت؛ چه شما یک علاقهمند تازهکار باشید و چه یک تحلیلگر SOC یا مدیر امنیت با تجربه.
خلاصه: پاسخ به حادثه مجموعهای از فرآیندها و اقدامات ساختاریافته است که سازمانها برای آمادهسازی، شناسایی، مهار، ریشهکنی و بازیابی از یک حادثه امنیتی به کار میگیرند. هدف اصلی آن، کاهش خسارت، بازگرداندن سریع سیستمها به حالت عادی و جلوگیری از تکرار حادثه مشابه در آینده است.
پاسخ به حادثه (Incident Response) چیست؟
پاسخ به حادثه به فرآیند شناسایی، مدیریت و کاهش اثرات یک رخداد امنیتی گفته میشود؛ رخدادی مثل نفوذ به شبکه، آلودگی به بدافزار (Malware)، نشت داده یا حمله باجافزاری (Ransomware). این فرآیند بخش فنی مدیریت حادثه (Incident Management) است و معمولاً در قالب یک سند رسمی به نام برنامه پاسخ به حادثه (Incident Response Plan) مستند میشود.
برنامه پاسخ به حادثه مشخص میکند که هر نوع حادثه چگونه شناسایی، دستهبندی، مهار و برطرف شود، چه کسی مسئول هر اقدام است و چطور بین تیمهای مختلف سازمان ارتباط برقرار میشود. نکته مهم این است که ارزش این برنامه فقط در لحظه حادثه نیست؛ مستندات آن بعداً برای اثبات مسئولیتپذیری سازمان نزد ممیزان، بیمهگران و حتی در دادگاه هم کاربرد دارد.
پاسخ به حادثه چیست و چرا با واکنش معمولی به یک خطای فنی فرق دارد؟
تفاوت اصلی در سرعت، ساختار و پیامدهای حقوقی و کسبوکاری ماجراست. یک خطای فنی معمولی معمولاً فقط نیاز به رفع اشکال دارد؛ اما یک حادثه امنیتی میتواند به نشت اطلاعات مشتریان، جریمههای قانونی و آسیب جدی به اعتبار برند منجر شود. به همین دلیل پاسخ به حادثه همیشه یک فرآیند مستند، زمانبندیشده و دارای مسئول مشخص است، نه یک اقدام موردی.
چرا پاسخ به حادثه برای سازمانها اهمیت حیاتی دارد؟
حوادث سایبری صرفاً مسئلهای فنی نیستند؛ آنها مسئلهای برای کل کسبوکار محسوب میشوند. هرچه زمان کشف و مهار یک حادثه کوتاهتر باشد، خسارت وارده هم کمتر خواهد بود. طبق گزارش هزینه نقض داده (Cost of a Data Breach) که هرساله توسط IBM منتشر میشود، سازمانهایی که تیم و برنامه رسمی پاسخ به حادثه دارند، هزینه هر نقض داده را بهطور محسوسی کاهش میدهند.
با این حال، بخش بزرگی از سازمانها هنوز آمادگی کافی ندارند. طبق یک نظرسنجی از مؤسسه Ponemon، حدود ۷۷ درصد از سازمانها فاقد یک برنامه پاسخ به حادثه رسمی و یکپارچه هستند و تنها بخش کوچکی از سازمانهایی که برنامه دارند، آن را «بالغ» توصیف میکنند. این در حالی است که هم مدتزمان رفع حوادث و هم شدت حملات، روندی رو به افزایش دارد.
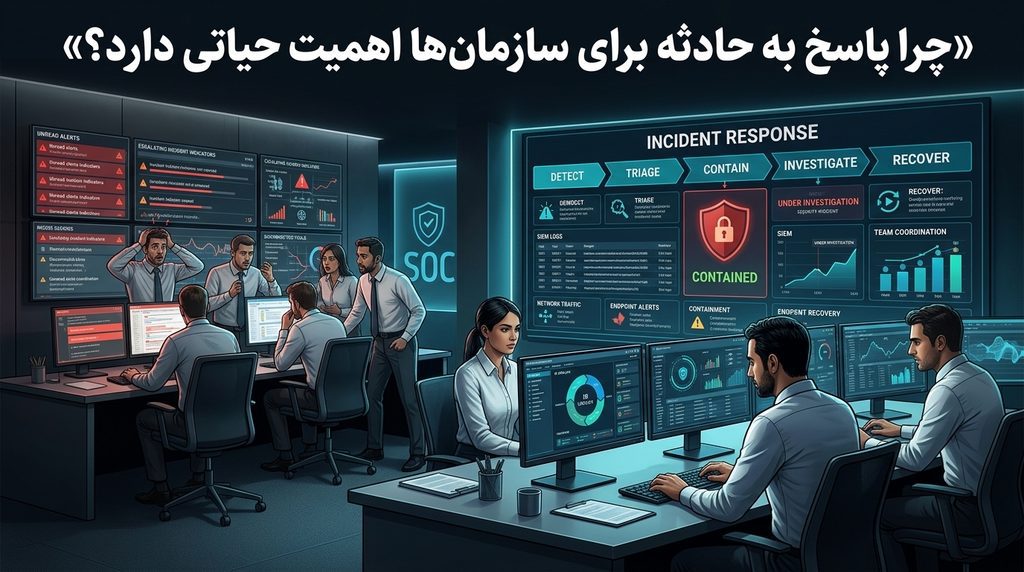
در تجربه متخصص شو در تولید محتوای آموزشی برای تحلیلگران SOC، دیدهایم بیشترین ضعف سازمانها نه در نبود ابزار، بلکه در نبود یک فرآیند مکتوب و تمرینشده است؛ زمانی که حادثه رخ میدهد، تیمها معمولاً میدانند چه ابزاری دارند اما نمیدانند دقیقاً چه کسی چه تصمیمی باید بگیرد.
چارچوبهای شناختهشده پاسخ به حادثه
برای اینکه پاسخ به حادثه یک اقدام سلیقهای نباشد، دو چارچوب اصلی در صنعت امنیت سایبری پذیرفته شدهاند.
مدل چهارمرحلهای NIST
مؤسسه ملی استاندارد و فناوری آمریکا (National Institute of Standards and Technology – NIST) پاسخ به حادثه را در چهار فاز اصلی تعریف میکند: آمادهسازی، شناسایی و تحلیل، مهار و ریشهکنی، و بازیابی پس از حادثه. این مدل به دلیل سادگی، در بسیاری از سازمانها بهعنوان پایه اصلی برنامهریزی استفاده میشود.
مدل ششمرحلهای SANS
مؤسسه SANS یک مدل تاکتیکی و دقیقتر با شش مرحله ارائه میدهد: آمادهسازی، شناسایی، مهار، ریشهکنی، بازیابی و درسآموختهها (Lessons Learned). در ادامه همین مدل ششمرحلهای را بهصورت عملی بررسی میکنیم، چون برای تیمهای عملیاتی کاربردیتر است.
مراحل عملی پاسخ به حادثه
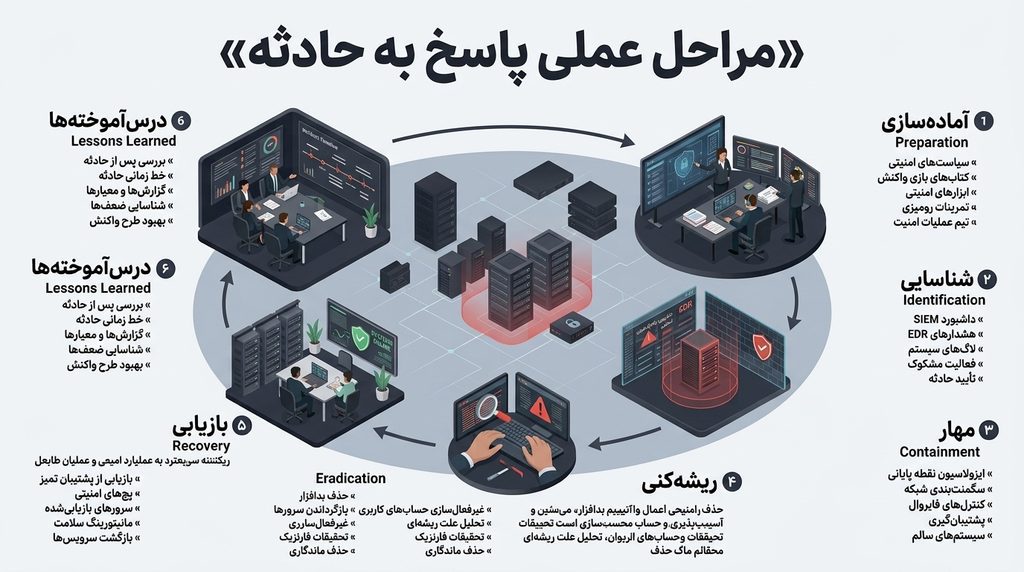
۱. آمادهسازی (Preparation)
این مرحله پیش از وقوع هر حادثهای انجام میشود و در واقع مهمترین بخش کل فرآیند است. در این فاز، تیم واکنش به حادثه سیاستها، نقشها و مسئولیتها را تعریف میکند، ابزارهای لازم را نصب میکند و سناریوهای احتمالی حمله را تمرین (Tabletop Exercise) میکند. هرچه این مرحله دقیقتر انجام شود، سرعت واکنش در لحظه بحران بیشتر خواهد بود.
۲. شناسایی (Identification)
در این فاز، تیم امنیت با استفاده از ابزارهایی مانند سامانه مدیریت اطلاعات و رویدادهای امنیتی (Security Information and Event Management – SIEM) و راهکارهای تشخیص و پاسخ نقطه پایانی (Endpoint Detection and Response – EDR) لاگها و هشدارها را بررسی میکند تا مشخص شود آیا واقعاً یک حادثه رخ داده یا صرفاً یک هشدار کاذب (False Positive) بوده است. دقت در این مرحله جلوی خستگی ناشی از حجم بالای هشدار (Alert Fatigue) را میگیرد.
۳. مهار (Containment)
وقتی حادثه تأیید شد، اولویت اول جلوگیری از گسترش آن است. مهار معمولاً دو سطح دارد: مهار کوتاهمدت مثل جداسازی سیستم آلوده از شبکه، و مهار بلندمدت مثل تقسیمبندی شبکه (Network Segmentation) برای محافظت از بخشهای سالم. در این مرحله معمولاً از سیستمهای آلوده نسخه پشتیبان (Backup) هم گرفته میشود تا شواهد فارنزیک از بین نرود.
۴. ریشهکنی (Eradication)
پس از مهار، نوبت به حذف کامل تهدید میرسد؛ از پاکسازی بدافزار گرفته تا بستن آسیبپذیری (Vulnerability) که مسیر ورود مهاجم بوده است. تحلیل علت ریشهای (Root Cause Analysis) در این مرحله انجام میشود تا اطمینان حاصل شود هیچ ردی از مهاجم در سیستم باقی نمانده است.
۵. بازیابی (Recovery)
در این فاز، سیستمهای آسیبدیده به حالت عملیاتی عادی بازمیگردند؛ معمولاً با نصب وصلههای امنیتی (Patch) و بازسازی از روی نسخههای پشتیبان سالم. تیم پاسخ به حادثه در این مرحله سیستمها را برای مدتی بهدقت زیر نظر میگیرد تا از عدم بازگشت تهدید مطمئن شود.
۶. درسآموختهها (Lessons Learned)
آخرین و شاید مهمترین مرحلهای است که خیلی از سازمانها آن را نادیده میگیرند. برگزاری یک جلسه بازبینی پس از حادثه با حضور همه ذینفعان کمک میکند نقاط ضعف فرآیند شناسایی شود و برنامه پاسخ به حادثه برای دفعه بعد بهروزرسانی شود.
تیم پاسخ به حادثه (CSIRT) و نقشهای کلیدی
مسئولیت اجرای این فرآیند بر عهده تیم پاسخ به حوادث امنیت رایانهای (Computer Security Incident Response Team – CSIRT) است. این تیم معمولاً از افراد زیر تشکیل میشود:
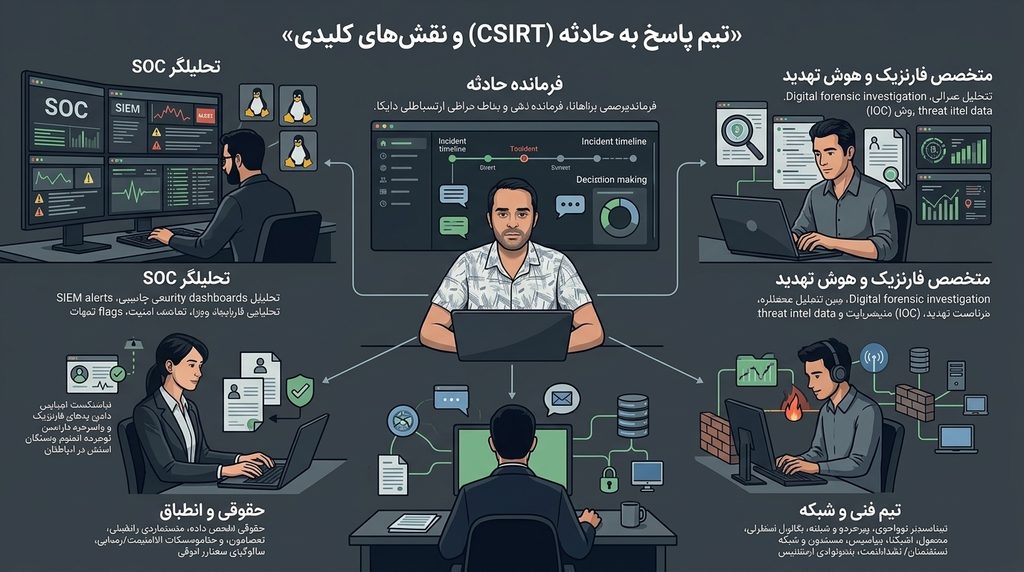
- رهبر حادثه (Incident Commander): تصمیمگیرنده اصلی و هماهنگکننده بین تیمها.
- تحلیلگر مرکز عملیات امنیت (SOC): پایش مداوم سیستمها، بررسی هشدارها و تشخیص اولیه حادثه.
- متخصص فارنزیک و تهدیدشناسی: تحلیل ریشهای حادثه و ردیابی رفتار مهاجم.
- تیم فنی و شبکه: اجرای اقدامات مهار و بازیابی روی زیرساخت.
- واحد حقوقی و انطباق: بررسی الزامات قانونی مثل گزارشدهی نقض داده به مراجع نظارتی.
- واحد ارتباطات: مدیریت پیامرسانی داخلی و بیرونی برای کاهش آسیب به اعتبار سازمان.
ابزارها و فناوریهای پاسخ به حادثه
در کنار فرآیند انسانی، مجموعهای از ابزارها سرعت و دقت واکنش را بالا میبرند:
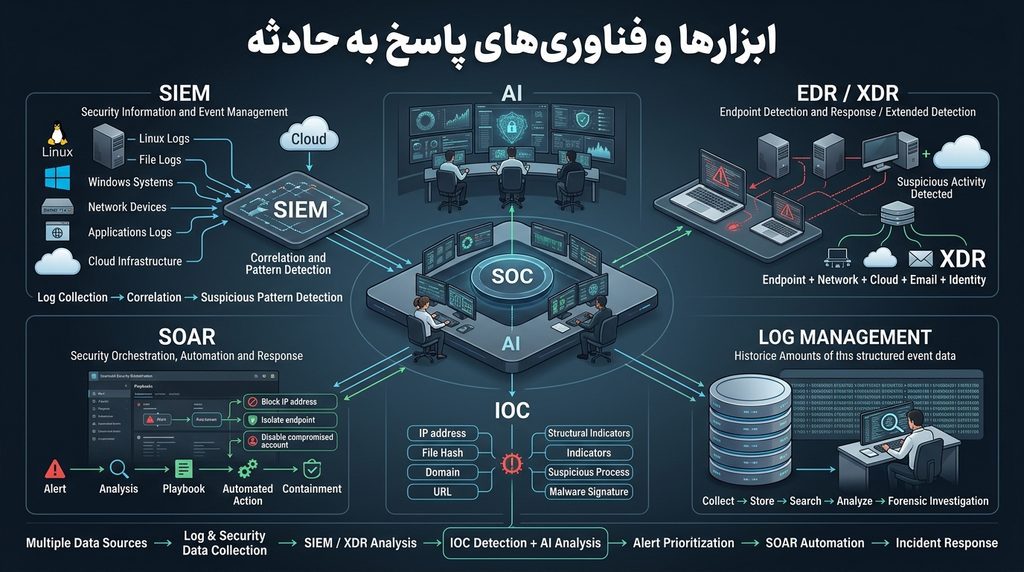
- SIEM: تجمیع و همبستگی (Correlation) لاگها از منابع مختلف برای شناسایی الگوهای مشکوک.
- EDR و XDR: پایش رفتار نقاط پایانی و در حالت XDR، یکپارچهسازی داده از چند لایه امنیتی برای دید جامعتر.
- SOAR: اتوماسیون بخشی از گردشکار پاسخ به حادثه با استفاده از پلیبوکهای از پیش تعریفشده.
- شاخصهای نفوذ (Indicators of Compromise – IOC): نشانههای فنی مثل آدرس IP یا هش فایل مخرب که برای شناسایی سریعتر حادثه استفاده میشوند.
- ابزارهای مدیریت لاگ: ذخیره و تحلیل تاریخچه رویدادها که در مرحله فارنزیک اهمیت زیادی دارد.
هوش مصنوعی (Artificial Intelligence – AI) هم بهتدریج جای پررنگتری در این حوزه پیدا کرده است؛ از تشخیص سریعتر ناهنجاریها تا اولویتبندی خودکار هشدارها، که هر دو بار کاری تیمهای SOC را کاهش میدهند.
مثال عملی: یک سناریوی واقعی از حمله باجافزار
فرض کنید یک کارمند روی پیوست یک ایمیل فیشینگ کلیک میکند و باتنت آلودهکننده روی سیستم او نصب میشود. تیم SOC از طریق هشدار EDR متوجه رفتار غیرعادی میشود (شناسایی)، بلافاصله سیستم را از شبکه جدا میکند (مهار)، بدافزار را حذف و آسیبپذیری ایمیل را میبندد (ریشهکنی)، سیستم را از روی بکاپ سالم بازمیگرداند (بازیابی) و در جلسه پایانی مشخص میکند که باید آموزش فیشینگ برای کارکنان تقویت شود (درسآموختهها).
یک اقدام ساده که همین امروز میتوانید انجام دهید: یک الگوی (Template) یکصفحهای از مراحل ششگانه بالا تهیه کنید و آن را در دسترس تیم فنی سازمانتان قرار دهید. همین سند ساده، سرعت واکنش شما را در اولین حادثه واقعی بهطور محسوسی بالا میبرد.
سؤالات متداول
پاسخ به حادثه بخش فنی ماجراست و روی شناسایی و رفع تهدید تمرکز دارد؛ در حالی که مدیریت حادثه (Incident Management) مفهومی گستردهتر است و ابعاد اجرایی، حقوقی و ارتباطی حادثه را هم شامل میشود.
معمولاً شامل نقشها و مسئولیتها، روشهای ارتباطی، رویههای فنی هر مرحله، لیست ابزارها و یک برنامه تداوم کسبوکار (Business Continuity) است.
به اندازه سازمان بستگی دارد. در شرکتهای کوچک ممکن است چند نفر چند نقش را همزمان بر عهده بگیرند؛ در سازمانهای بزرگتر معمولاً یک تیم اختصاصی CSIRT وجود دارد.
خیر. حتی یک هشدار کوچک هم باید طبق همان فرآیند بررسی شود، چون خیلی از حملات بزرگ با یک نشانه کوچک و نادیدهگرفتهشده شروع میشوند.
در محیط ابری، مدل مسئولیت مشترک (Shared Responsibility) بین سازمان و ارائهدهنده سرویس ابری اهمیت زیادی پیدا میکند و تیم باید با ابزارهای بومی همان پلتفرم ابری هم آشنا باشد.
جمعبندی
پاسخ به حادثه یک فرآیند ششمرحلهای مستمر است که با آمادهسازی شروع و با درسآموختهها تمام میشود؛ نه یک اقدام یکباره در لحظه بحران. سازمانی که این فرآیند را از قبل مستند و تمرین کرده باشد، هم خسارت کمتری میبیند و هم سریعتر به روال عادی برمیگردد.
اگر هنوز برنامه مکتوبی برای پاسخ به حادثه در سازمان یا تیم خودتان ندارید، همین امروز شروع کنید: نقشها را مشخص کنید و شش مرحله بالا را روی کاغذ بیاورید. این اولین قدم برای تبدیلشدن از یک تیم واکنشی به یک تیم آماده است.

 چیست؟ راهنمای کامل)
بدون دیدگاه